
CSVファイルをChatGPT、Claude、Geminiにアップロードして、質問するだけです。方法はこれがすべてで、ちゃんと動きますし、たいていのファイルにはこれで十分です。ただし、大事なデータで使う前に知っておきたいことが2つあります。ファイルの中身がすべて端末の外に出ること。そして、返ってきた数字が信頼できるかどうかは、モデルがコードを実行して求めたかどうかで決まることです。
先に結論
- 機密でないファイルで本格的に分析したい: ChatGPT、Claude、Geminiにアップロードして質問します。そのあと、自分がすでに知っている数字1つと答えを照らし合わせてください。
- 顧客データ、給与データ、銀行データ: 行をアップロードしてはいけません。AIには列名だけを送り、返ってきたクエリをローカルで実行するツールを使います。
- 毎回正確な数字がほしい: チャットはやめて、SQLで聞きます。AIはクエリを書くのが得意で、信頼できるのはクエリのほうです。
チャットAIはCSVを実際にどう読んでいるか
チャットボットがファイルに対してできることは、大きく異なる2通りあります。そしてどちらが起きたのか、画面からは分からないことがあります。
コードを実行する場合。 ChatGPT、Claude、Geminiはいずれも、短いプログラム(たいていはpandasを使ったPython)を書き、サンドボックス内でファイルに対して実行し、結果を報告できます。この場合、合計は全行を対象にした本物の合計です。多くの場合、コードか、展開できる「思考」や「分析」のステップが表示されます。
テキストを読む場合。 CSVがテキストとして会話に貼り付けられ、モデルは「見えた」内容から答えます。「どんな列がありますか」や「このデータを説明して」なら問題ありません。しかし「売上の合計はいくらですか」には向きません。言語モデルに4,000個の数字を頭の中で足させると、自信満々に数字を返しますが、その数字は間違っています。
唯一のルール: 使うつもりの数字は、必ず実行したコードを見せてもらってください。コードがなければ、計算はされていません。
大きなファイルでは、後者になる可能性が高まります。モデルのコンテキストに収まらないファイルは、テキストとして読む際に切り詰められたりサンプリングされたりし、答えは見えた部分についてのものになります。
3大アシスタントの比較
| 使い方 | 得意なこと | 注意点 | |
|---|---|---|---|
| ChatGPT | CSVを添付して質問 | グラフ、ピボット、クリーニング、新しいファイルでの返却 | スプレッドシートのファイルサイズ上限。コードが実行されたか確認 |
| Claude | CSVを添付して質問 | 見慣れないファイルの中身の説明、丁寧な推論 | 同じく、推定ではなく分析の実行を依頼する |
| Google スプレッドシートのGemini | CSVをスプレッドシートで開き、Geminiのサイドパネルを使う | すでにスプレッドシートにあるデータ、残しておける数式 | スプレッドシート自体の1,000万セルの上限が先に効く |
3つとも上限をよく変更するので、ここに数字を書いても次の四半期には古くなります。変わらないのは、聞いてから検証するというやり方です。
うまくいくプロンプト
あいまいな質問にはあいまいな答えが返ってきます。列名と操作を指定しましょう。
- 「
amount列とcategory列を使って、categoryごとのamountの合計を大きい順に並べて。コードも見せて。」 - 「
emailが空の行は何行ある?最初の10件のidを挙げて。」 - 「
order_dateごとのamountの月次合計を折れ線グラフにして。」 - 「何か答える前に、読み込んだ行数と列数を教えて。」
最後の1文が、このガイドでいちばん役に立ちます。報告された行数がファイルの行数と合っていなければ、その後の答えはあなたのファイルについてのものではありません。
端末から出ていくもの
CSVをチャットAIにアップロードすると、すべてのセルがプロバイダーのサーバーに送られます。保存されるかどうか、学習に使われるかどうかは、プランと設定しだいです。これはこのガイドではなく、プロバイダーのプライバシーのページで確認することです。
公開データなら問題ありません。しかしCRMのエクスポート、給与ファイル、銀行の明細、個人情報を含むものなら、判断できるのは自分ではないことが多いでしょう。勤務先の規則や、住んでいる国の法律がすでに答えを決めているかもしれません。
行をアップロードせずに聞く
CSVにAIを使うもう1つの方法があり、データが機密のときはこちらを使います。AIにはファイルの中身ではなく構造を送ります。
- AIに渡すのは、質問と列名だけです。
- AIがクエリ(たいていはSQL)を書きます。
- クエリは自分のマシンで、自分のファイルに対して実行されます。
モデルは値を1つも見ないので、漏らしようがありません。計算はクエリエンジンが行うため、頭の中で計算を間違えることもありません。これはどのチャットボットでも手作業でできます。ヘッダー行だけを貼り、DuckDBのクエリを書いてもらい、自分で実行するだけです。やり方はCSVでSQLを使うガイドで説明しています。
スマートフォンでは、Smart CSV Viewerのアシスタントがまさにこの仕組みで動きます。質問を入力すると、質問と列名だけがサーバーに送られます。返ってきたフィルターはスマートフォン上で実行され、テーブルに適用する前に、一致した行を確認できます。
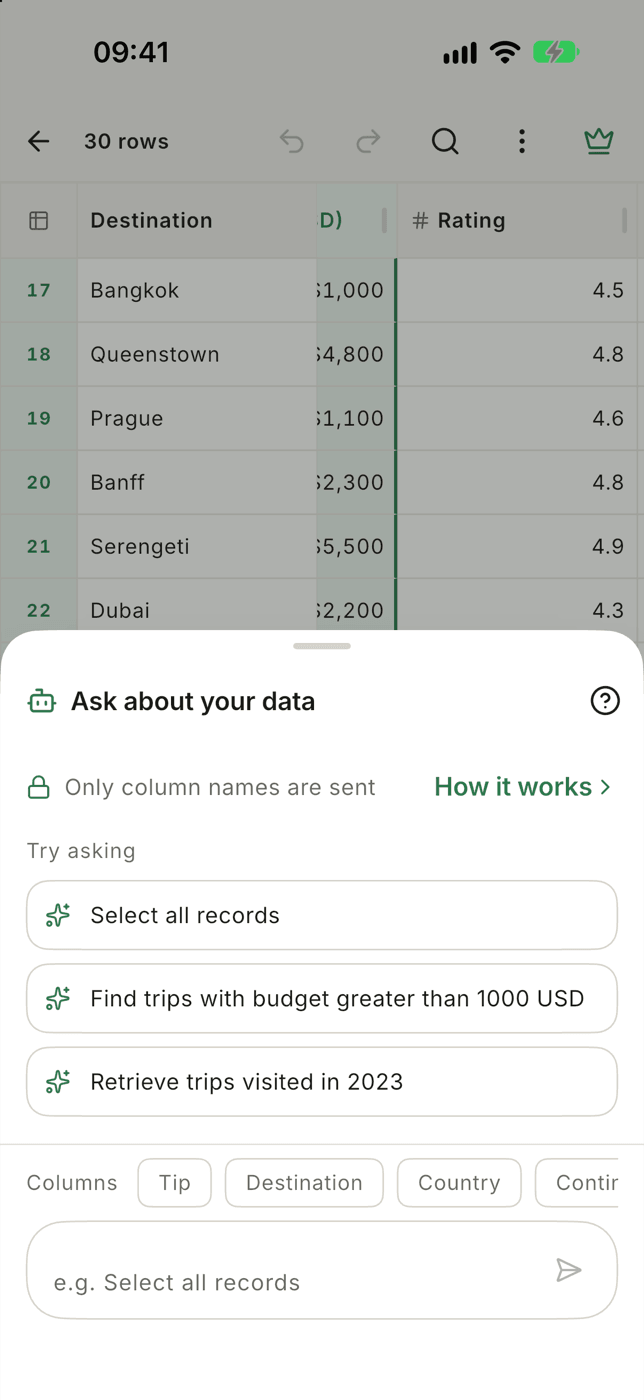
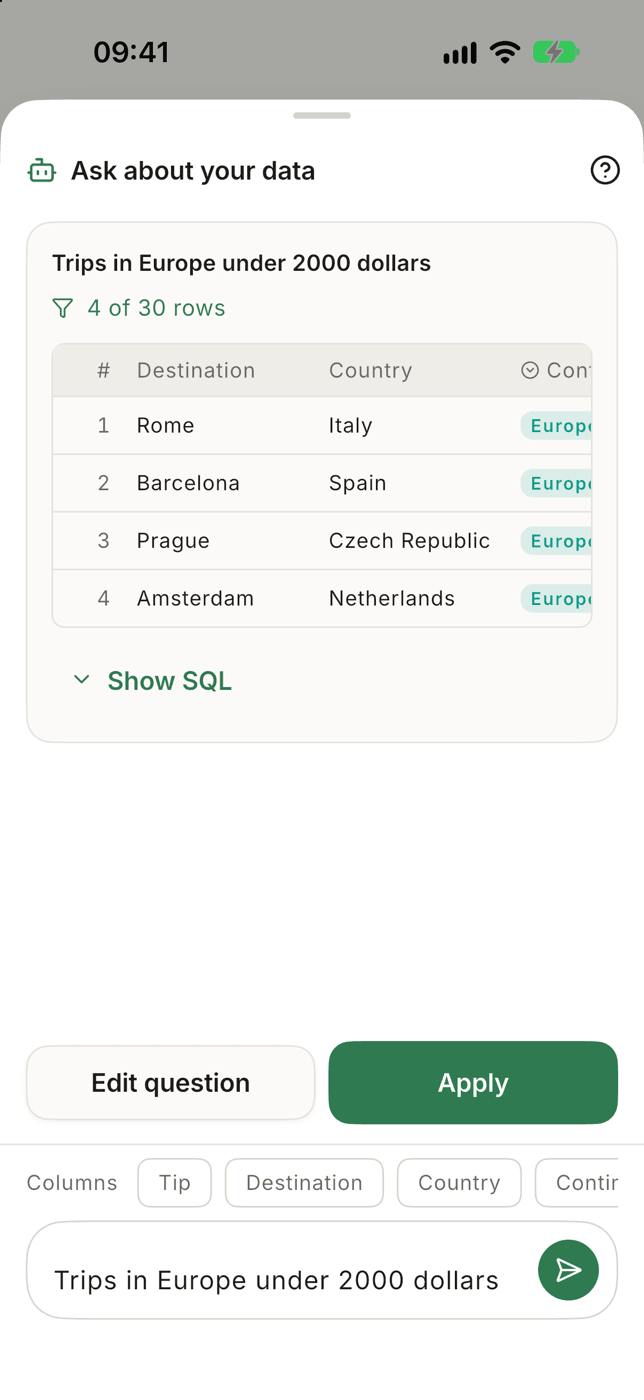
回答カードのShow SQLを押すと、実行したクエリが表示されます。先ほどの「コードを見せてもらう」ルールが、最初から組み込まれているわけです。
iPhoneやAndroidで、CSVについて普通の言葉で質問できます。スマートフォンから出るのは質問と列名だけ。フィルターはローカルで実行され、SQLもワンタップで確認できます。
できることできないこともあります。レポートを書くツールではありません。行を見つけ、絞り込み、並べ替えるだけです。「このファイルを3段落で要約して」なら、チャットAIと、それに伴うアップロードが必要です。
AIの答えを30秒で確認する方法
どのツールを使うにしても、AIが出した数字をスライドに貼る前に確認してください。
- 行数。 ファイルと一致していますか。(デスクトップなら
wc -l、またはビューアに表示される件数。) - 既知の合計1つ。 先月の売上など、ダッシュボードなど別の方法で確かめられる数字を選んで聞いてみます。それが間違っていれば、ほかの数字も間違っています。
- フィルター条件。 「ドイツの顧客は何人」なら、使われた条件を見てください。
country = 'Germany'では、DE、germany、末尾に空白のあるGermanyが漏れます。AIは分かりやすいクエリを書きますが、実際のデータが分かりやすいことはめったにありません。
AIが向かないとき
- 繰り返しのレポート。 毎週月曜に同じ質問をするなら、クエリを一度書いて保存します。チャットボットは仕組み上、毎回少しずつ違う答えを返します。
- 巨大なファイル。 数百MBを超えると、遅いのはアップロードです。DuckDBのようなローカルのエンジンなら、アップロードが終わる前に答えが出ます。1GBのCSVファイルを開く方法をご覧ください。
- データ自体が間違っている。 日付の半分が
MM/DDで、残りの半分がDD/MMになっていても、聞かない限りAIは教えてくれません。まずファイルを自分の目で見ましょう。