JSON é uma árvore. CSV é um retângulo. Converter um no outro significa decidir como achatar a árvore, e todo conversor toma essas decisões por você, quase sempre sem dizer o que decidiu. Por isso o mesmo arquivo passado por três conversores online pode gerar três planilhas diferentes.
Se você conhece as três decisões, pode escolher a ferramenta, ou as configurações, que as tomam do jeito que você quer.
A resposta rápida
- Um array simples de objetos (
[{"id":1,"name":"Ada"}, …]): qualquer conversor serve. Usejq, Python, DuckDB, Excel ou um app. - Objetos aninhados (
"address": {"city": "Leeds"}): achate em colunas com ponto,address.city. Ojson_normalizedo Python faz isso em uma linha. - Arrays dentro de cada registro (
"tags": ["a","b"]): decida entre uma coluna por item, uma linha por item ou uma única célula com a lista unida. Não existe resposta certa, só a que serve para o que você vai fazer com os dados. - Os registros não estão na raiz: encontre primeiro o array (geralmente
data,itemsouresults) e converta esse.
Decisão 1: qual array vira as linhas?
Um CSV precisa de uma lista de coisas parecidas, uma por linha. Quase nenhum JSON real começa com uma. A resposta de uma API é assim:
{
  "status": "ok",
  "page": 1,
  "data": {
    "items": [
      { "id": 1, "name": "Ada", "address": { "city": "Leeds" }, "tags": ["admin"] },
      { "id": 2, "name": "Lin", "address": { "city": "Hue" }, "tags": [] }
    ]
  }
}
As linhas estão em data.items. Um conversor apontado para a raiz vê um único
objeto e devolve uma linha com status, page e uma coluna cheia de JSON
escapado. Essa é a reclamação mais comum de "o conversor está quebrado", e é um
problema de caminho, não do conversor.
Decisão 2: o que acontece com objetos aninhados?
address é um objeto dentro de cada registro. A solução usual, e a certa para a
maioria dos casos, é achatá-lo em nomes de coluna com ponto:
| id | name | address.city |
|---|---|---|
| 1 | Ada | Leeds |
| 2 | Lin | Hue |
A alternativa, colocar o objeto inteiro numa célula como string JSON, mantém tudo, mas deixa você com uma coluna que não dá para ordenar nem filtrar.
Decisão 3: o que acontece com arrays dentro de um registro?
tags é uma lista, e uma lista não cabe em uma célula. Três opções:
| Abordagem | Resultado | Boa para |
|---|---|---|
| Colunas indexadas | tags[0], tags[1], … | Listas curtas com máximo conhecido |
| Expandir em linhas | Uma linha por tag, demais colunas repetidas | Contar ou filtrar por tag |
| Unir em uma célula | admin;editor | Ler, não analisar |
Expandir muda o número de linhas: uma pessoa com três tags vira três linhas. Isso está certo para "quantas pessoas têm cada tag" e errado para "quantas pessoas existem". Decida para qual pergunta o CSV serve antes de escolher.
As outras perdas
Mesmo um achatamento perfeito perde coisas, porque o CSV não consegue expressá-las:
- Tipos.
"42"e42viram42.truevira o textotrue. - Nulo ou vazio.
null,""e uma chave ausente viram uma célula vazia. - Colunas de registros esparsos. Se só um registro em 10.000 tem um campo
coupon, um conversor que monta o cabeçalho com as chaves do primeiro registro vai descartá-lo. Bons conversores usam a união das chaves de todos os registros.
Com jq
Para um array simples na raiz:
jq -r '(.[0] | keys_unsorted) as $k | $k, (.[] | [.[$k[]]]) | @csv' in.json > out.csv
Isso monta o cabeçalho a partir do primeiro registro, então perde qualquer
chave que ele não tenha, que é o problema dos registros esparsos mencionado
acima. Para um array mais abaixo, troque o primeiro . pelo caminho, como
.data.items. Com dados aninhados o jq consegue, mas a expressão deixa de ser
legível; use Python.
Com Python
pandas.json_normalize toma as três decisões em uma chamada e usa a união das
chaves:
import json, pandas as pd

data = json.load(open("in.json"))
df = pd.json_normalize(data["data"]["items"], sep=".")
df.to_csv("out.csv", index=False)
Objetos aninhados viram address.city. Listas continuam como listas em uma
célula; para expandi-las em linhas, adicione df = df.explode("tags") antes de
salvar.
Com DuckDB
Para arquivos grandes, o DuckDB lê JSON diretamente e grava CSV sem carregar tudo na memória:
duckdb -c "COPY (SELECT * FROM read_json_auto('in.json')) TO 'out.csv'"
Para um array simples, é o caminho mais rápido que existe. Objetos aninhados
saem na notação struct própria do DuckDB, em uma única coluna, então desaninhe-os
no SELECT ou use Python para dados aninhados.
Com Excel
Dados → Obter Dados → Do Arquivo → De JSON abre o Power Query. Clique em Para Tabela e depois no ícone de expandir no cabeçalho da coluna (duas setas) para expandir registros e listas nível por nível. É de apontar e clicar, e você vê cada decisão enquanto a toma. Depois salve como CSV. Atenção às conversões de tipo na saída: o Excel altera os dados do CSV a menos que você peça para não alterar.
Conversores online
Funcionam, e para dados públicos servem bem. Dois cuidados. A maioria esconde as três decisões, então compare o número de linhas e colunas do resultado com o que você esperava. E o JSON de uma API costuma ter tokens, e-mails ou registros de clientes, então prefira um conversor que rode no navegador sem enviar nada.
No iPhone e no iPad
O Smart Json converte JSON em CSV no que chama de modo de registros: um array de
objetos vira as linhas, valores aninhados são achatados em colunas com ponto
(address.city, tags[0]) e o cabeçalho é a união das chaves de todos os
registros. Ele encontra o primeiro array de objetos para você e deixa você
escolher outro, ou digitar um JSONPath como $.data.items. O separador é
configurável, e um documento sem array de objetos avisa isso em vez de gerar um
despejo inútil de duas colunas.
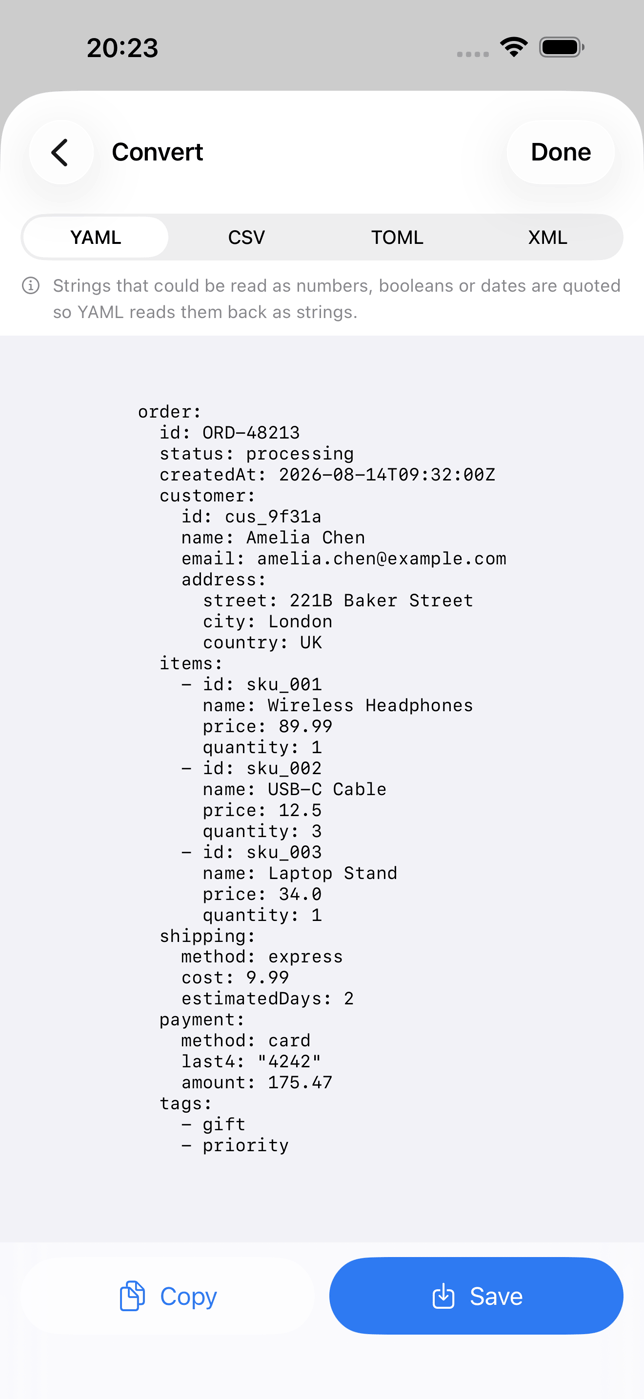
A prévia é grátis, então você vê exatamente como o CSV vai ficar. Copiar ou salvar o resultado é Pro.
Mostra o JSON como CSV na prévia, com valores aninhados achatados em colunas com ponto, deixa você escolher o array de registros por JSONPath e diz claramente o que o CSV não consegue guardar.
O que ele fazDepois que virou CSV, abri-lo no celular é um probleminha à parte; esse guia cobre o assunto.
Confira o resultado
Seja qual for a ferramenta, três verificações:
- Número de linhas. Bate com o número de registros do array (ou é maior, se você expandiu uma lista de propósito)?
- Número de colunas. Um campo que aparece só em alguns registros chegou ao cabeçalho?
- Um valor aninhado. Escolha um registro com objeto aninhado e confirme que o valor caiu na coluna com ponto certa.